上一篇记录了 agent swarm 的几篇新工作,写完之后一直在想一个更基础的问题:我们到底为什么需要和研究 multi-agent system?这从 2023 年 ChatDev、MetaGPT 、斯坦福小镇等等,到去年 “Don’t Build Multi-Agents”,再到今年 OpenAI 用上万个 agent 去做 Navier–Stokes,随着模型能力的不断提升,任务场景的持续变难,我想这个问题的答案一直在变。
总体来说,MAS 的理由有三版,每一次对应的出发点不一样,一个 agent 的单位也不一样:
- 分工:原初的分工理念,把 LLM 组织起来,一个 agent 是一个具体“角色”;
- 上下文:把长任务拆给 subagent,一个 agent 是一个干净的上下文窗口;
- 探索:工作和探索空间太大了,一个 agent 是一条独立任务的长时轨迹。
第一节点原初分工理念基本上被快速迭代的基模能力吃掉了,上下文管理近期基本成为了公认的规范,也涌现了大量相关工作,逐渐走向成熟。最后一点探索是一个很有意思的新话题,这个场景下我们在纯粹scale agent的数目。我希望做一个比喻是类似llm parameters的scaling,有些能力会在超过一定参数的时候涌现,我们也希望随着我们提高合作agent的数目,他们能去解决一些仅靠基模无法解决的问题。
一、分工,原始的组织设想
最早一批 MAS 的思路非常直接:人类做复杂的事靠组织和分工,那就让 LLM 也扮演不同角色。
- CAMEL 用 role-playing 搭建复杂异步的多智能体模拟;
- Generative Agents 在 Smallville 里放了 25 个有记忆、反思和计划的 agent,虽然是社会模拟而不是解题,但”agent 社会”这个想象基本是从这里开始的;
- ChatDev 直接开了一家虚拟软件公司,CEO、CTO、程序员、reviewer、tester 按瀑布流程两两对话;
- MetaGPT 更进一步,把 SOP 编码成 prompt 序列,角色之间传的不是闲聊,而是 PRD、接口文档这些结构化产物;
- AutoGen 把这一切抽象成可编程的 agent 对话;
- Multiagent Debate 则去掉了角色,让同一个模型的多个副本互相看答案、辩论、修正。
这一阶段隐含的假设是:一个模型不够好,拆成不同角色、各司其职,质量就会上来。但现在回头看,这个假设有个很根本的问题:所有角色都是同一个模型。”CTO”和”程序员”的差别只在 system prompt,分工只是 prompt 层面的偏置,不是能力上的差异。
后面几篇工作从不同角度证明了prompt构建的原初性分工并没有很高的现实意义:
- More Agents Is All You Need 发现,什么复杂框架都不用,同一个模型采样 N 次再投票,效果就随 agent 数量上涨,Llama2-13B 用 15 个 agent 投票就能追平单个 Llama2-70B;
- Debate or Vote 把 debate 拆成投票和辩论两部分,发现大部分收益其实来自 majority voting,并且证明辩论本身并不提高期望正确率;
- Rethinking the Bounds of LLM Reasoning 发现单 agent 只要 prompt 里给一个好的 demonstration(75.63),就和最好的多 agent 讨论框架(74.46)差不多;

最有说服力的是 Berkeley 的 MAST(Why Do Multi-Agent LLM Systems Fail?)。他们分析了 ChatDev、MetaGPT 等 7 个开源 MAS 的 1,600 多条轨迹,失败率在 41% 到 86.7% 之间,总结出 14 种失败模式,集中在系统设计、agent 之间不对齐和缺少验证三类。很有意思的一个数字是,”不遵守角色设定”只占 1.5%:问题从来不是 agent 演不好角色,而是步骤重复、不知道什么时候该停、推理和行动对不上这些协作本身带来的问题。在 ChatDev 上加一层高层验证能提升 15.6%,比把角色写得更清楚(+9.4%)更有用。

顺带一提,MacNet 在这一时期已经把 agent 数拉到上千,提出了 collaborative scaling law:效果随 agent 数量呈 logistic 增长,大多在 100 个左右饱和。这算是最早把”agent 数量”当成 scaling 维度的尝试,但放在分工这个框架里,收益很快就到头了。
这个阶段是MAS相对早期的一个发展阶段,分工本身不是 MAS 的本质。角色扮演没有带来新的信息或能力,增益很大一部分是”多采样了几次”,而自由对话又引入了新的失败方式。真正留下来的是几样东西:结构化的交接(MetaGPT 的文档)、可执行的反馈,以及验证。等模型变强、单 agent + 工具足够好用之后,这种”虚拟公司”式的 MAS 基本就淡出了。
二、上下文:一切为了干净的上下文
2025 年 MAS 重新被重视,但理由完全变了:一切为了干净的上下文。
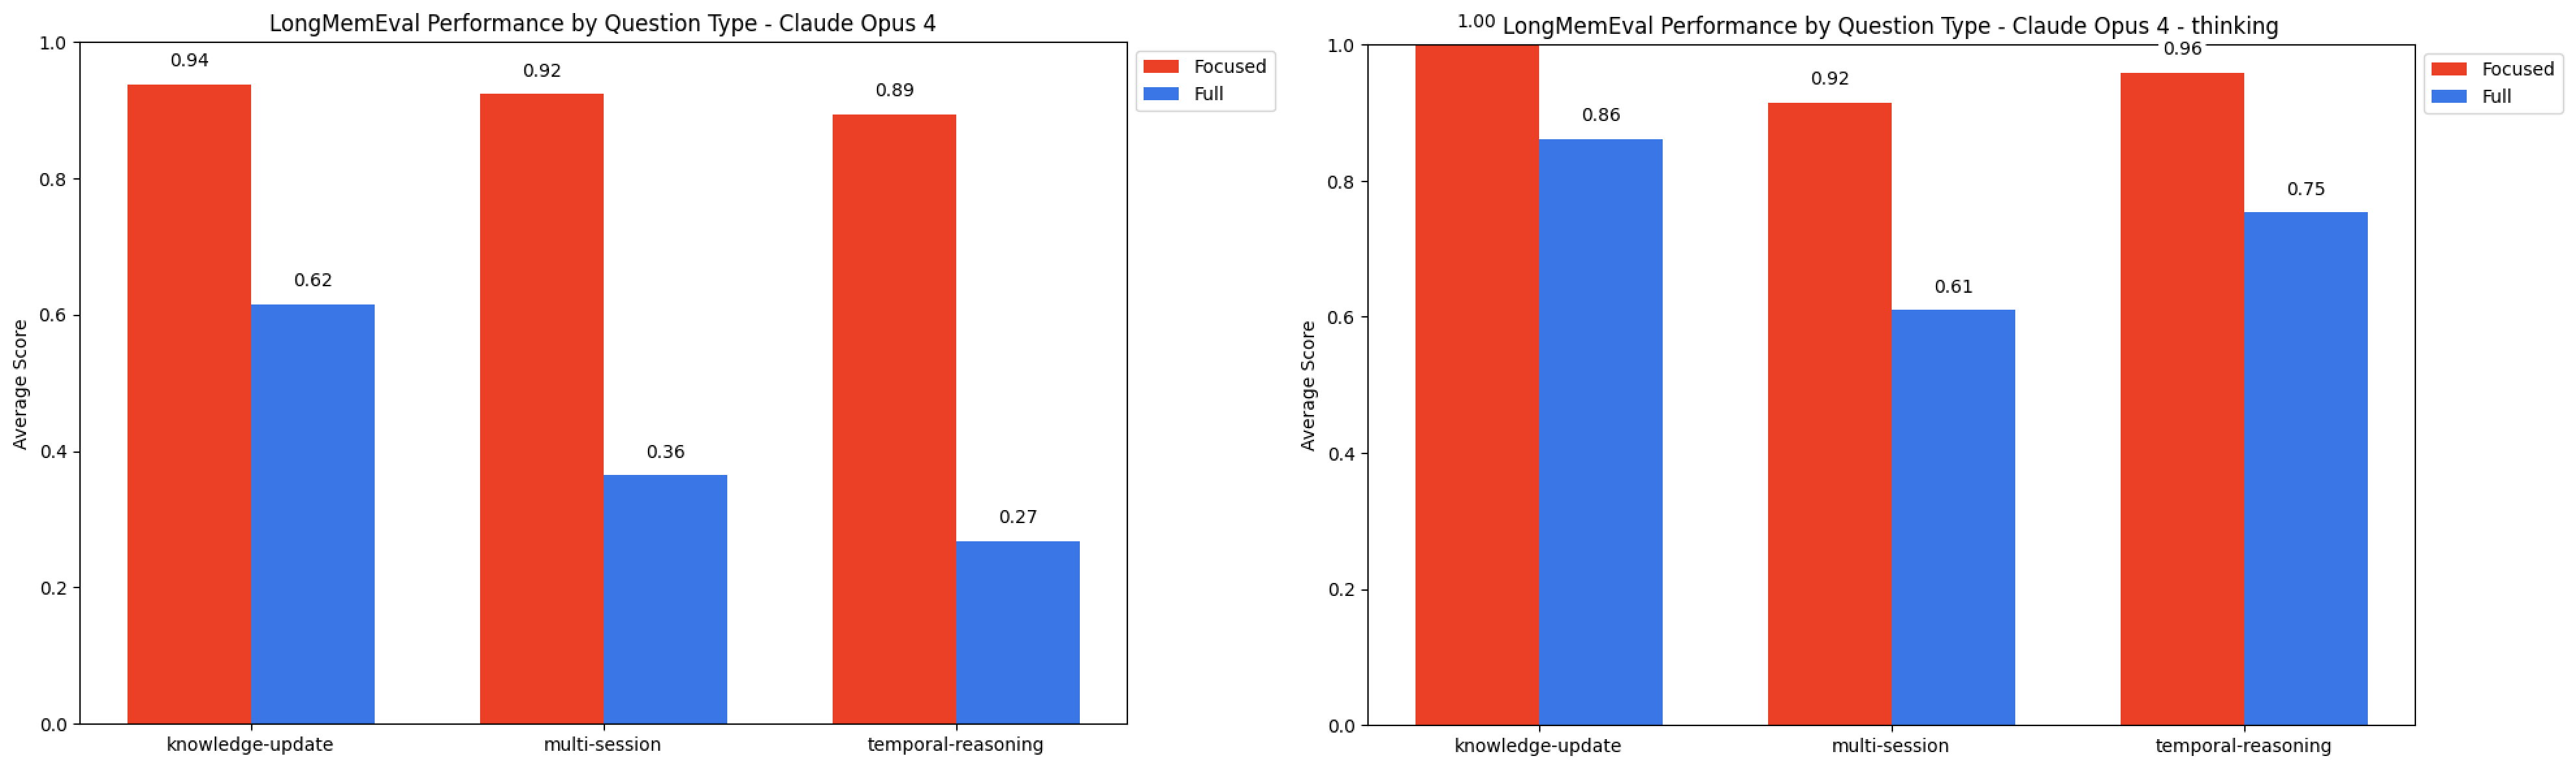
长程任务里,单 agent 真正的瓶颈是上下文会越来越脏。这件事很早就有证据:Lost in the Middle 发现相关信息放在长上下文中间时效果明显变差,最差的时候甚至不如不给文档(closed-book 56.1%)。Chroma 的 Context Rot 测了 18 个模型,结论更直接:同样的问题,只给相关的约 300 token(focused)比给完整的约 113k token(full)好得多。比如 Claude Opus 4 在 multi-session 题上,focused 是 0.92,full 只有 0.36。信息都在上下文里,模型也不一定用得好。
于是 MAS 变成了一种上下文管理手段。最有代表性的是 Anthropic 的 multi-agent research system:lead agent 负责规划,并行拉起 3–5 个 subagent 各自搜索,每个 subagent 在自己的上下文里探索,最后只把压缩后的结果交回来。当时的一些结论:
- Opus 4 做 lead、Sonnet 4 做 subagent,在内部 research eval 上比单 agent 的 Opus 4 高 90.2%;
- 在 BrowseComp 上,光 token 用量一个因素就解释了 80% 的效果方差(加上 tool call 次数和模型选择,三个因素共 95%);
- 代价是 multi-agent 系统的 token 消耗大约是普通对话的 15 倍。
“The essence of search is compression.”
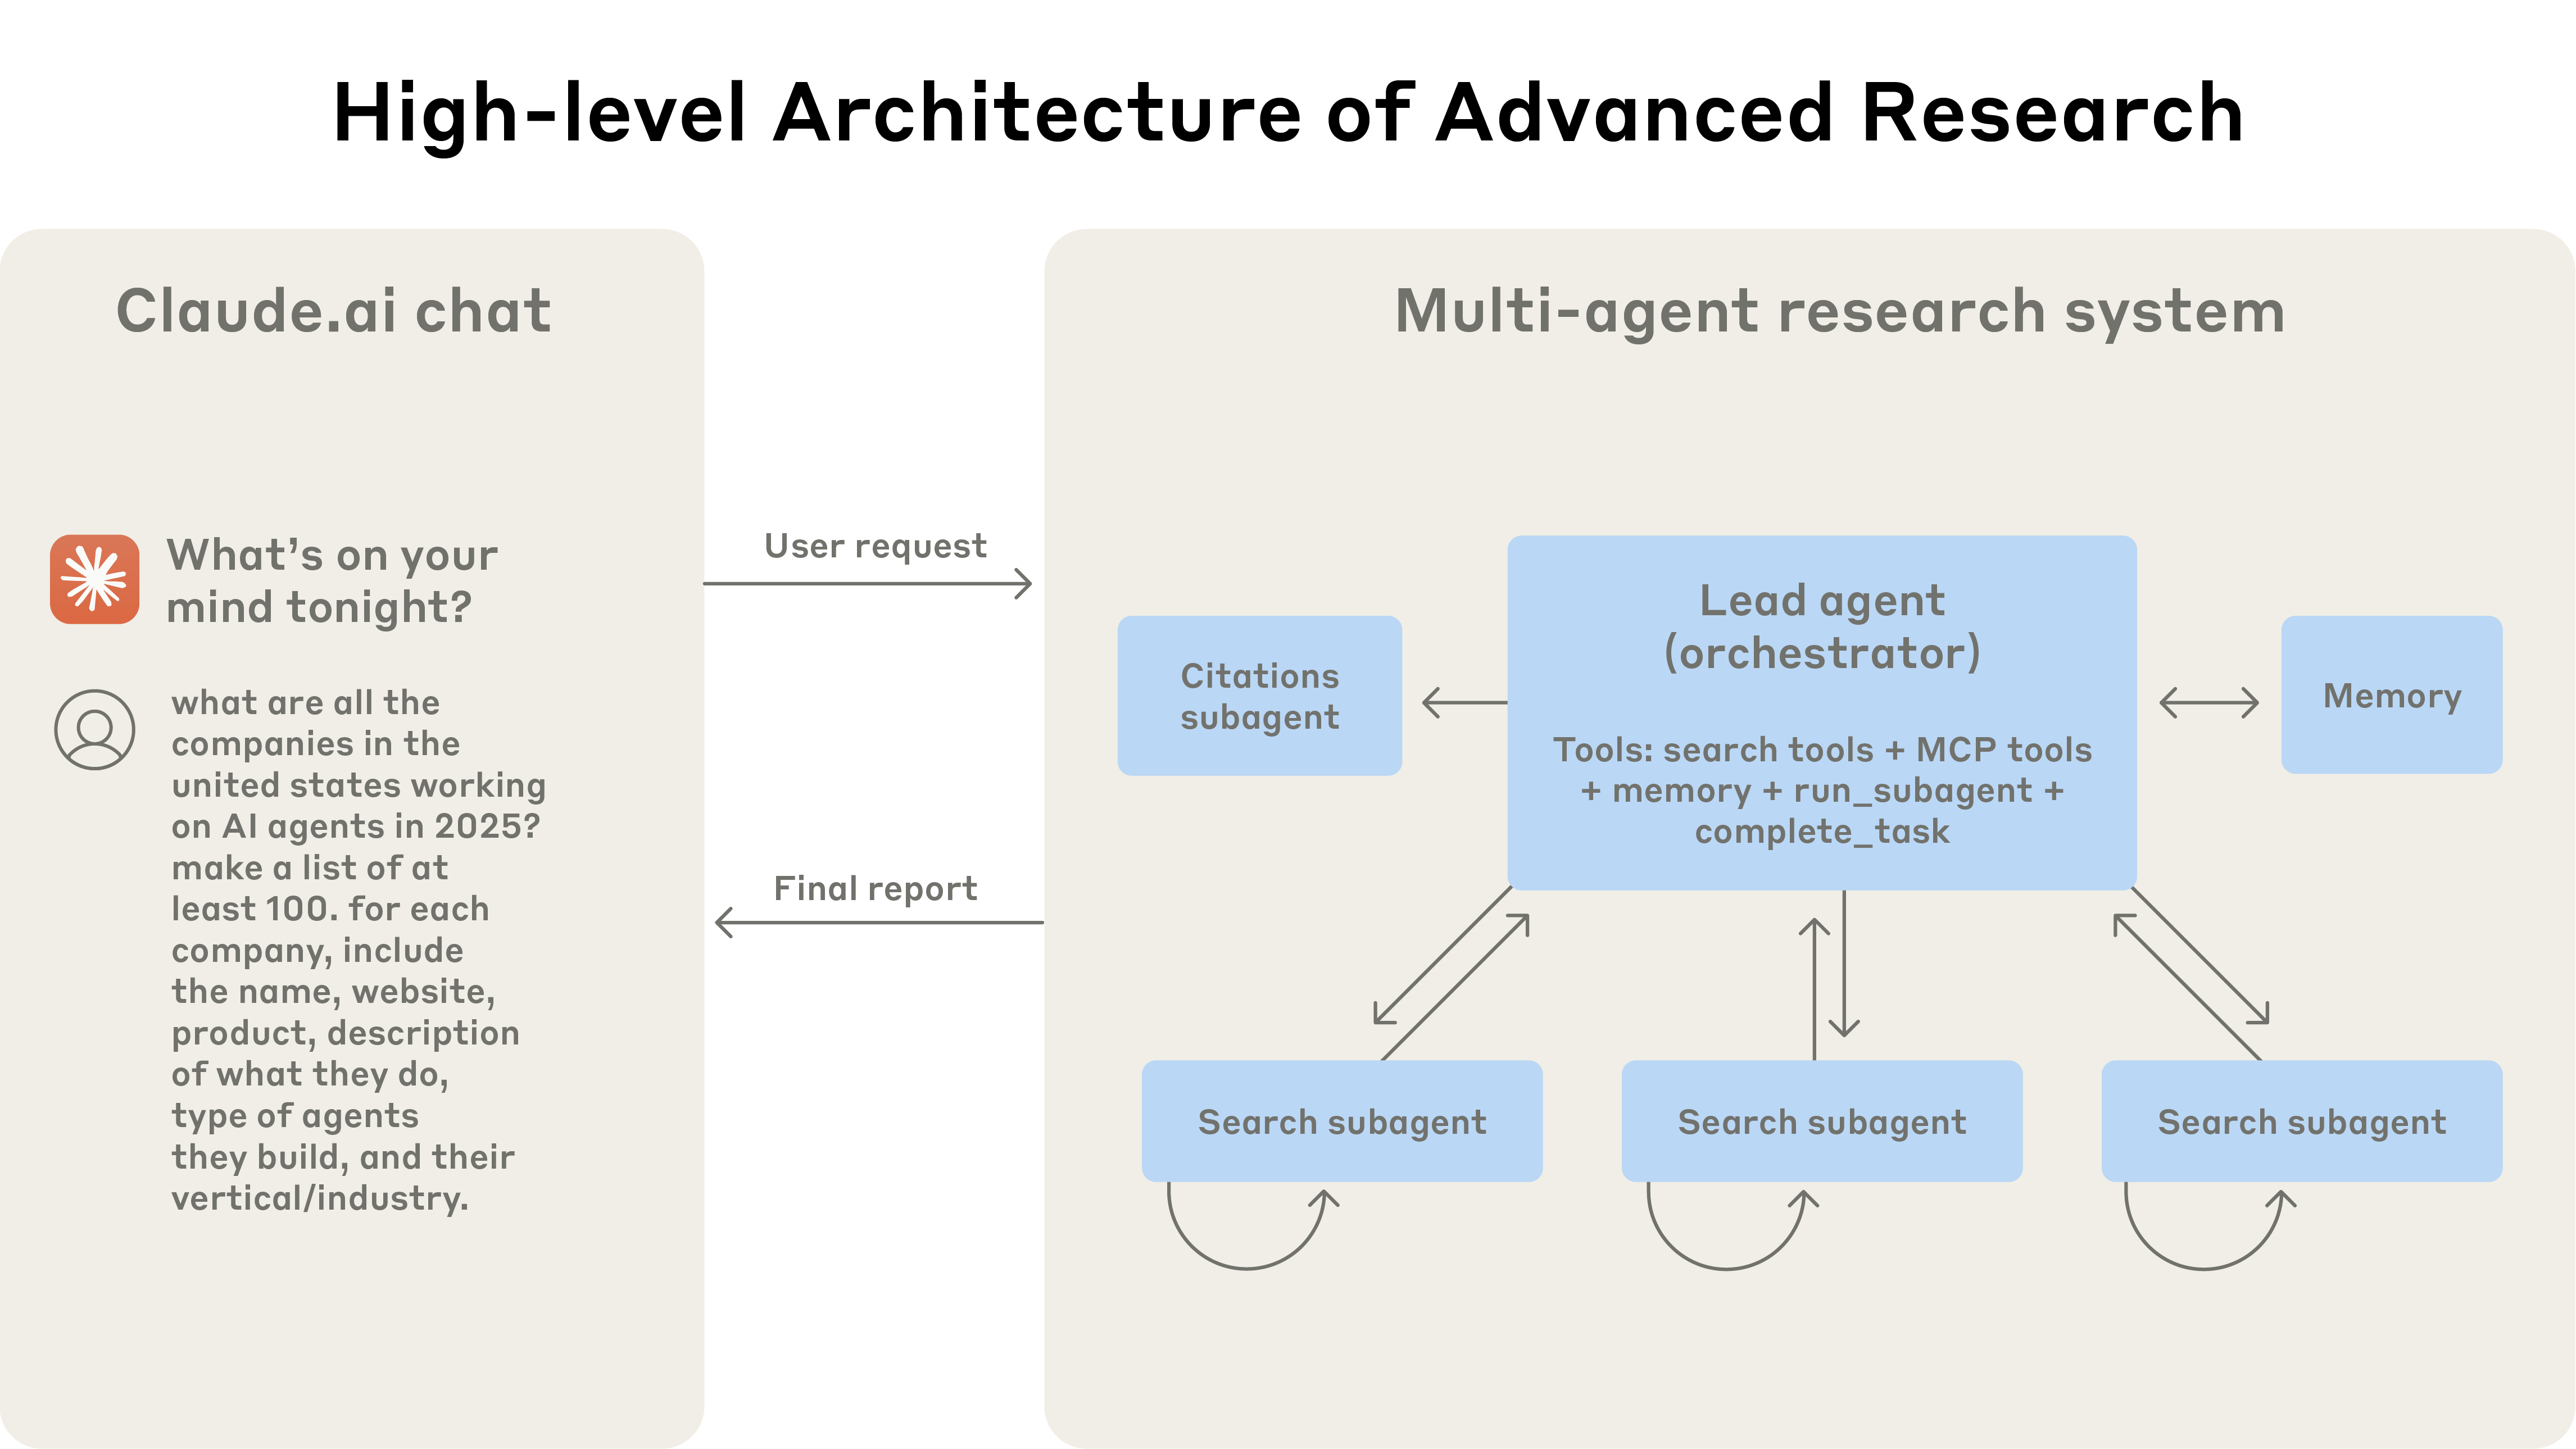
我觉得第 2 点是这一阶段的核心:MAS 本质上是一种把 token 花出去的方式。一个上下文窗口装不下、也用不好那么多 token,那就拆成多个干净的窗口并行去花,再把结果压缩回来。Anthropic 后来那篇 context engineering 讲得更明白:subagent 可能用几万 token 去探索,但只交回 1,000–2,000 token 的总结。
但这个阶段也有很强的反对声音。Cognition 的 Don’t Build Multi-Agents 提了两条原则:一是要共享完整的 trace,而不只是消息;二是 “Actions carry implicit decisions”,每个 subagent 的行动都隐含了决策,决策一冲突结果就坏了(他们举的例子是做 Flappy Bird,一个 subagent 画了马里奥风格的背景,另一个画了一只风格完全不搭的鸟)。Google 的 Towards a Science of Scaling Agent Systems 做了对照实验,把工具、prompt、计算量固定住,比较单 agent 和几种 multi-agent 结构:
- 能拆的任务收益很大,比如金融分析用中心化 MAS 提升 80.8%;
- 强顺序依赖的任务全线下降,PlanCraft 上各种 MAS 都掉了 39% 到 70%;
- 独立 agent 会把错误放大 17.2 倍,有中心化验证也有 4.4 倍;
- 单 agent 准确率超过 45% 左右之后,再加 agent 就是负收益。

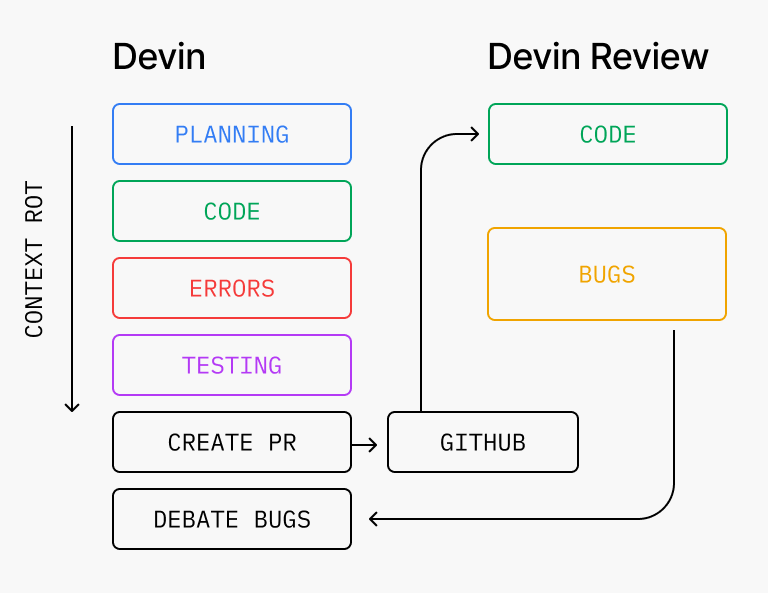
到今年,大家基本收敛到一个折中:读可以并行,写保持单线程。连 Cognition 自己今年 4 月的 Multi-Agents: What’s Actually Working 也承认,多个 agent 一起贡献”智力”、但写操作留在一条线程里的模式是有效的。比如让一个上下文干净的 review agent 去看代码:它不共享写代码过程中的上下文,反而更聪明。
还有两个方向说明”编排”本身也在变成可学习的东西。Recursive Language Models 把超长 prompt 当成 REPL 里的一个变量,让模型自己写代码去切分、递归调用自己。Kimi K2.5 的 Agent Swarm 用 PARL 直接 RL 训练 orchestrator 去拆任务、拉起最多 100 个 subagent,BrowseComp 从单 agent 的 60.6 涨到 78.4。
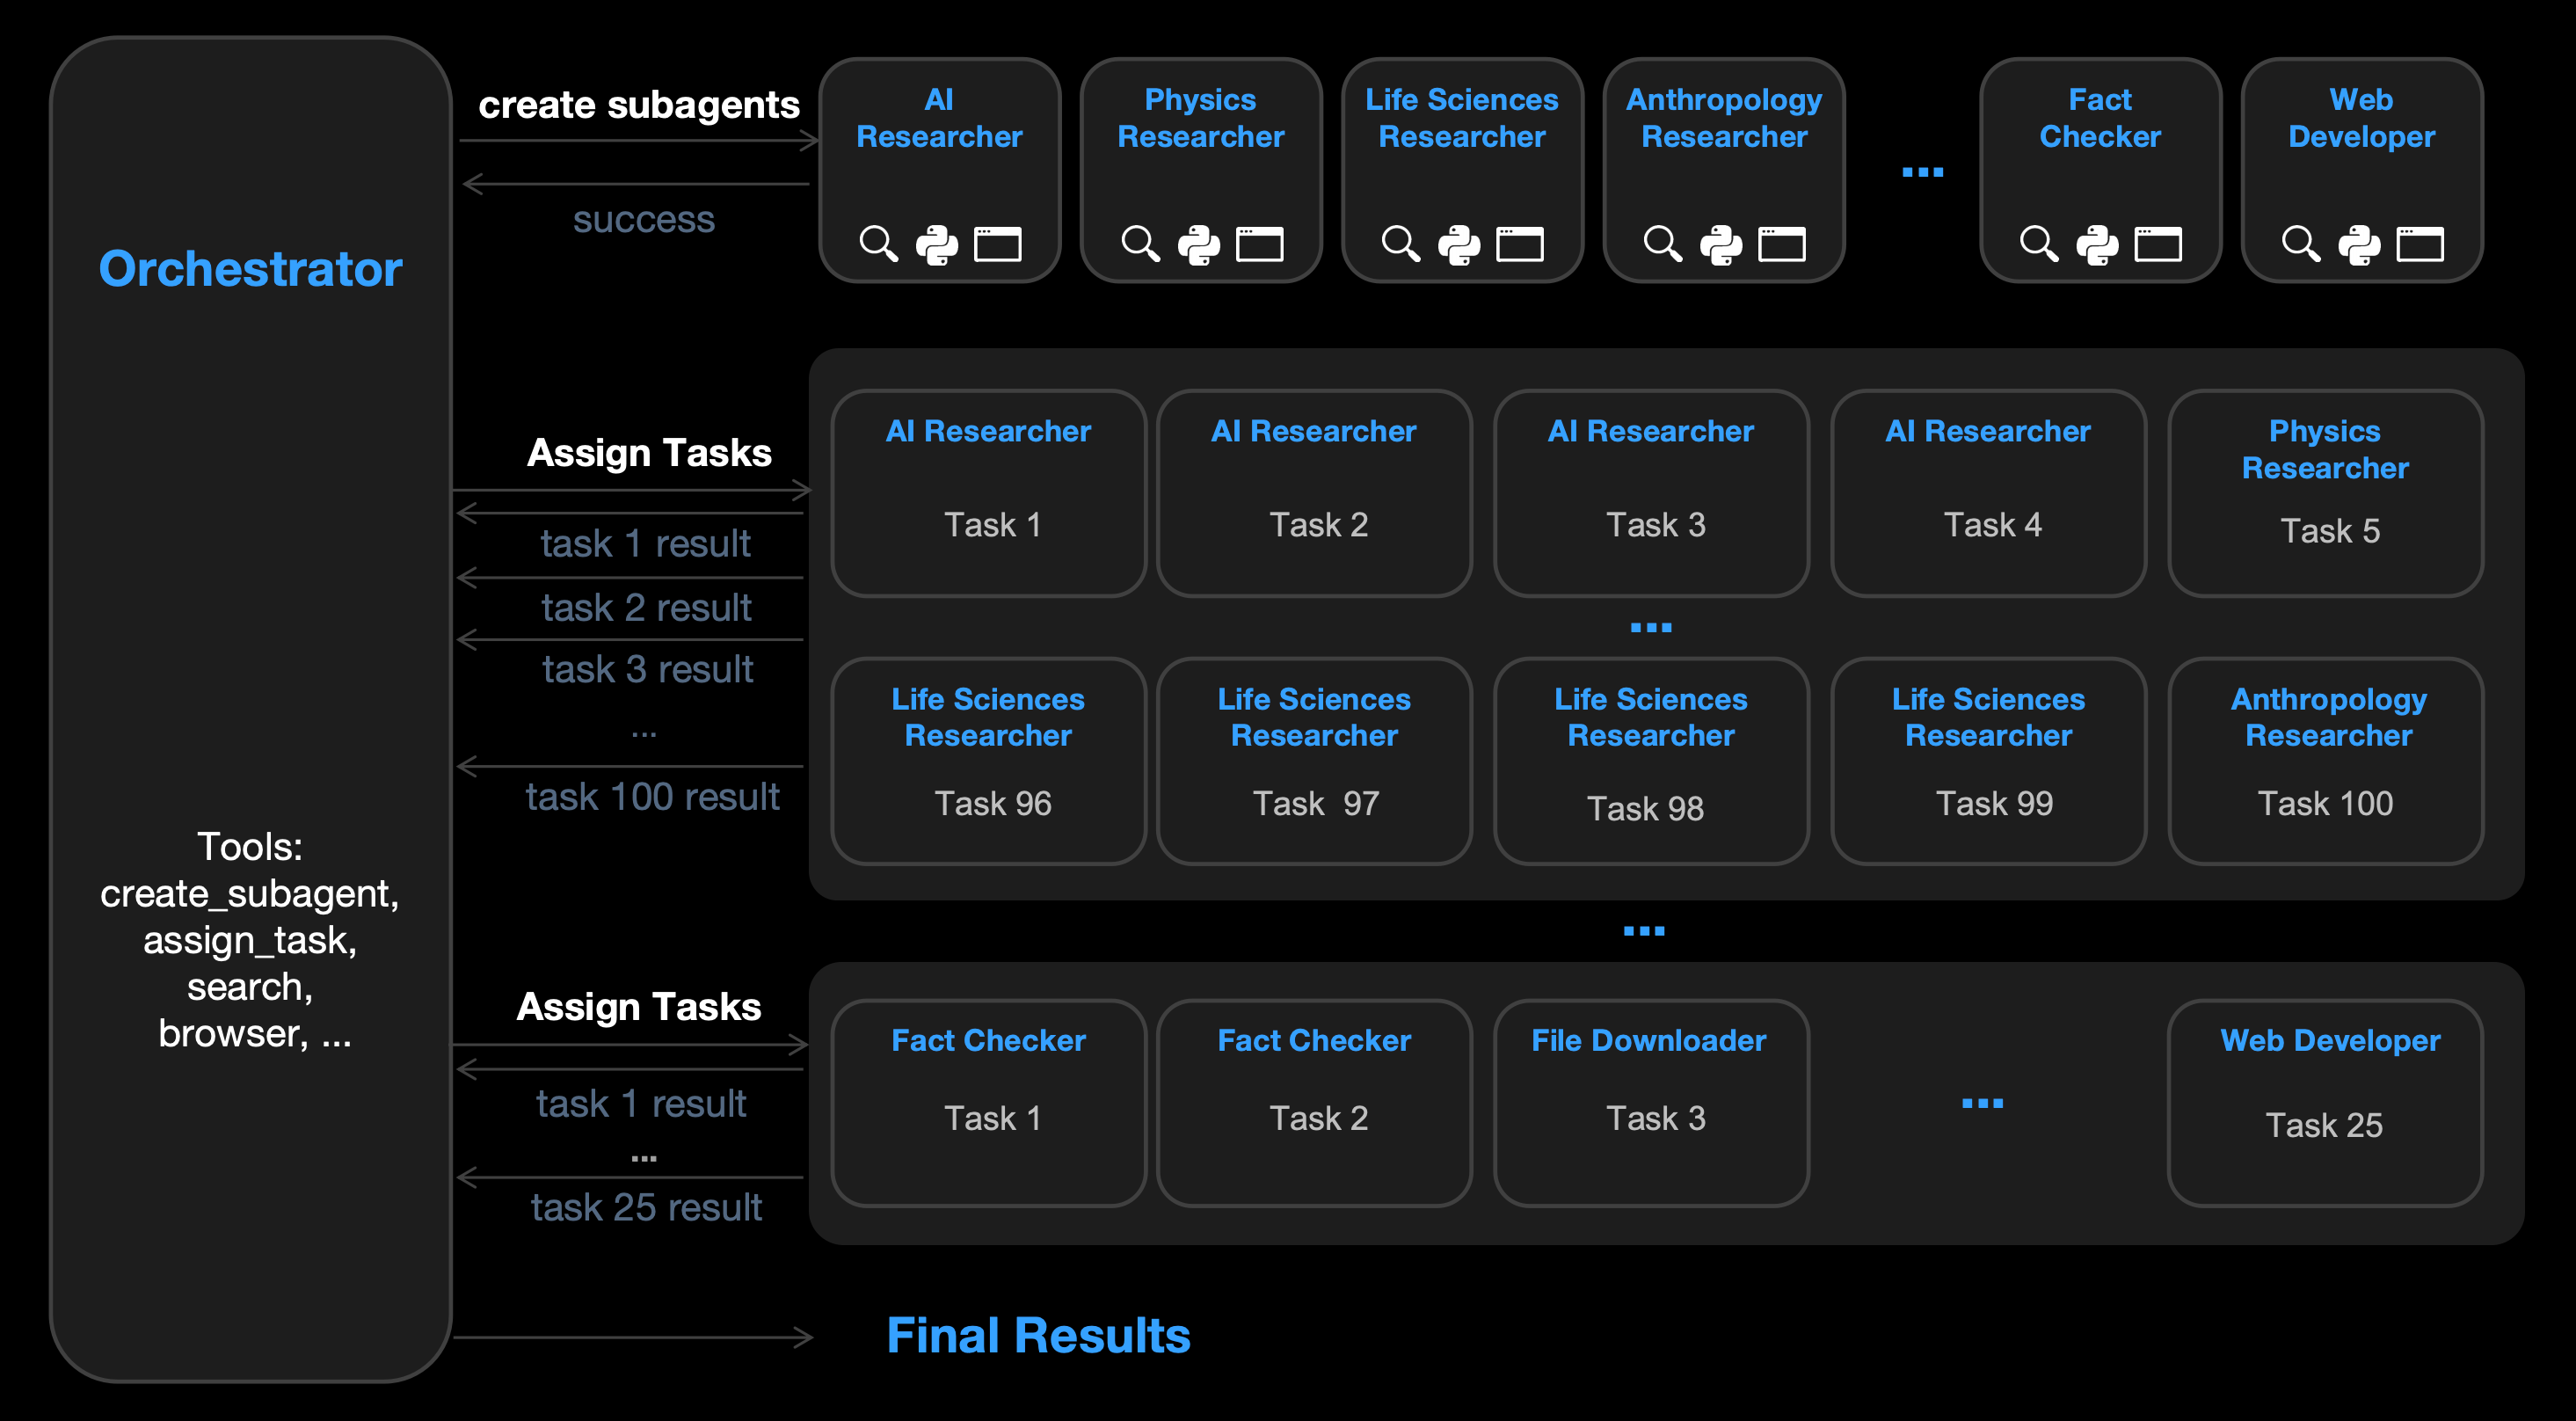
所以这一阶段,一个 agent 的单位是一个上下文窗口,MAS = 上下文管理 + 并行。它是真实有效的,但是这条路线更倾向于流程的拆分:任务边界是清楚的,orchestrator 知道怎么拆,subagent 是在帮一条主线收集信息。问题空间本身并没有变大。
三、Swarm:巨大的工作和探索空间
这个阶段其实本质的矛盾和优化点从agent转移到了task。我们关心的并不是agent如何优化上下文,更好地完成编排或者某个任务;而是这个问题本身有非常多需要并行去做的东西,互相直接可能有联系、可能没联系,怎么探索这个问题更高效。
科学发现和开放问题恰恰是这种情况:可能的方向非常多,大部分是死路,好结果极度长尾,而且一开始谁也不知道哪条路是对的。这时候就算上下文无限长、编排完美,一个 agent 也只是在一棵巨大的搜索树里走一条路径。这一阶段 MAS 要解决的不是”一个模型不够好”,也不只是”一个窗口装不下”,而是工作和探索空间本身太大了,我们需要”scale single intelligence for higher intelligence”。
当然这个假设也有一个更切实一点的解释。假设任务要经过 \(T\) 个阶段,单个 agent 在第 \(t\) 个阶段成功的概率是 \(p_t\)。\(k\) 个独立 agent 互不交流,就必须有一个 agent 自己走通全程:
\[P_{\text{best@}k} = 1 - \left(1 - \prod_{t=1}^{T} p_t\right)^{k}\]而如果每个阶段的已验证进展可以共享,那么每个阶段只需要 \(k\) 个里面有一个成功,其他人就能站在它的基础上继续:
\[P_{\text{team@}k} = \prod_{t=1}^{T} \left(1 - (1 - p_t)^{k}\right)\]\(T\) 一大,前者里的 \(\prod_t p_t\) 会指数级变小,再多的独立抽卡也救不回来;后者只要 \(k\) 够大,每一项都接近 1。这也解释了为什么在短任务(数学题、AIME)上 best@k 就够了,而在长程的开放任务上交流才显出价值。
有意思的是,这里”角色”又回来了,但和第一阶段方向正好相反:不是一开始写死的 CEO、CTO,而是规模变大之后为了协作自然分化出来的。
工程上几个大规模实践也说明了同样的事,以及它的边界:
- Anthropic 用 16 个 Claude 并行写 C 编译器,大约 2,000 个 session、不到 2 万美元,写出了一个 10 万行、能编译 Linux 6.9 的 Rust 编译器。协调机制非常朴素:共享 git,写一个文件来锁任务,测试当 oracle。最有意思的教训是,编译内核是 “one giant task”,16 个 agent 撞上同一个 bug、互相覆盖修复;解决办法是拿 GCC 当已知正确的 oracle,每个 agent 只用自己的编译器编一部分内核,把一个大任务重新切成可以并行的小任务。
- Cursor 的 Scaling long-running autonomous coding 让几百个 agent 用将近一周写出了一个超过 100 万行的浏览器。他们先试了扁平的自协调加锁,结果 20 个 agent 的有效吞吐只相当于两三个;后来改成 planner 递归拆任务、worker 埋头干活、judge 决定是否继续的层级结构才跑起来,他们的说法是结构”somewhere in the middle”最好。
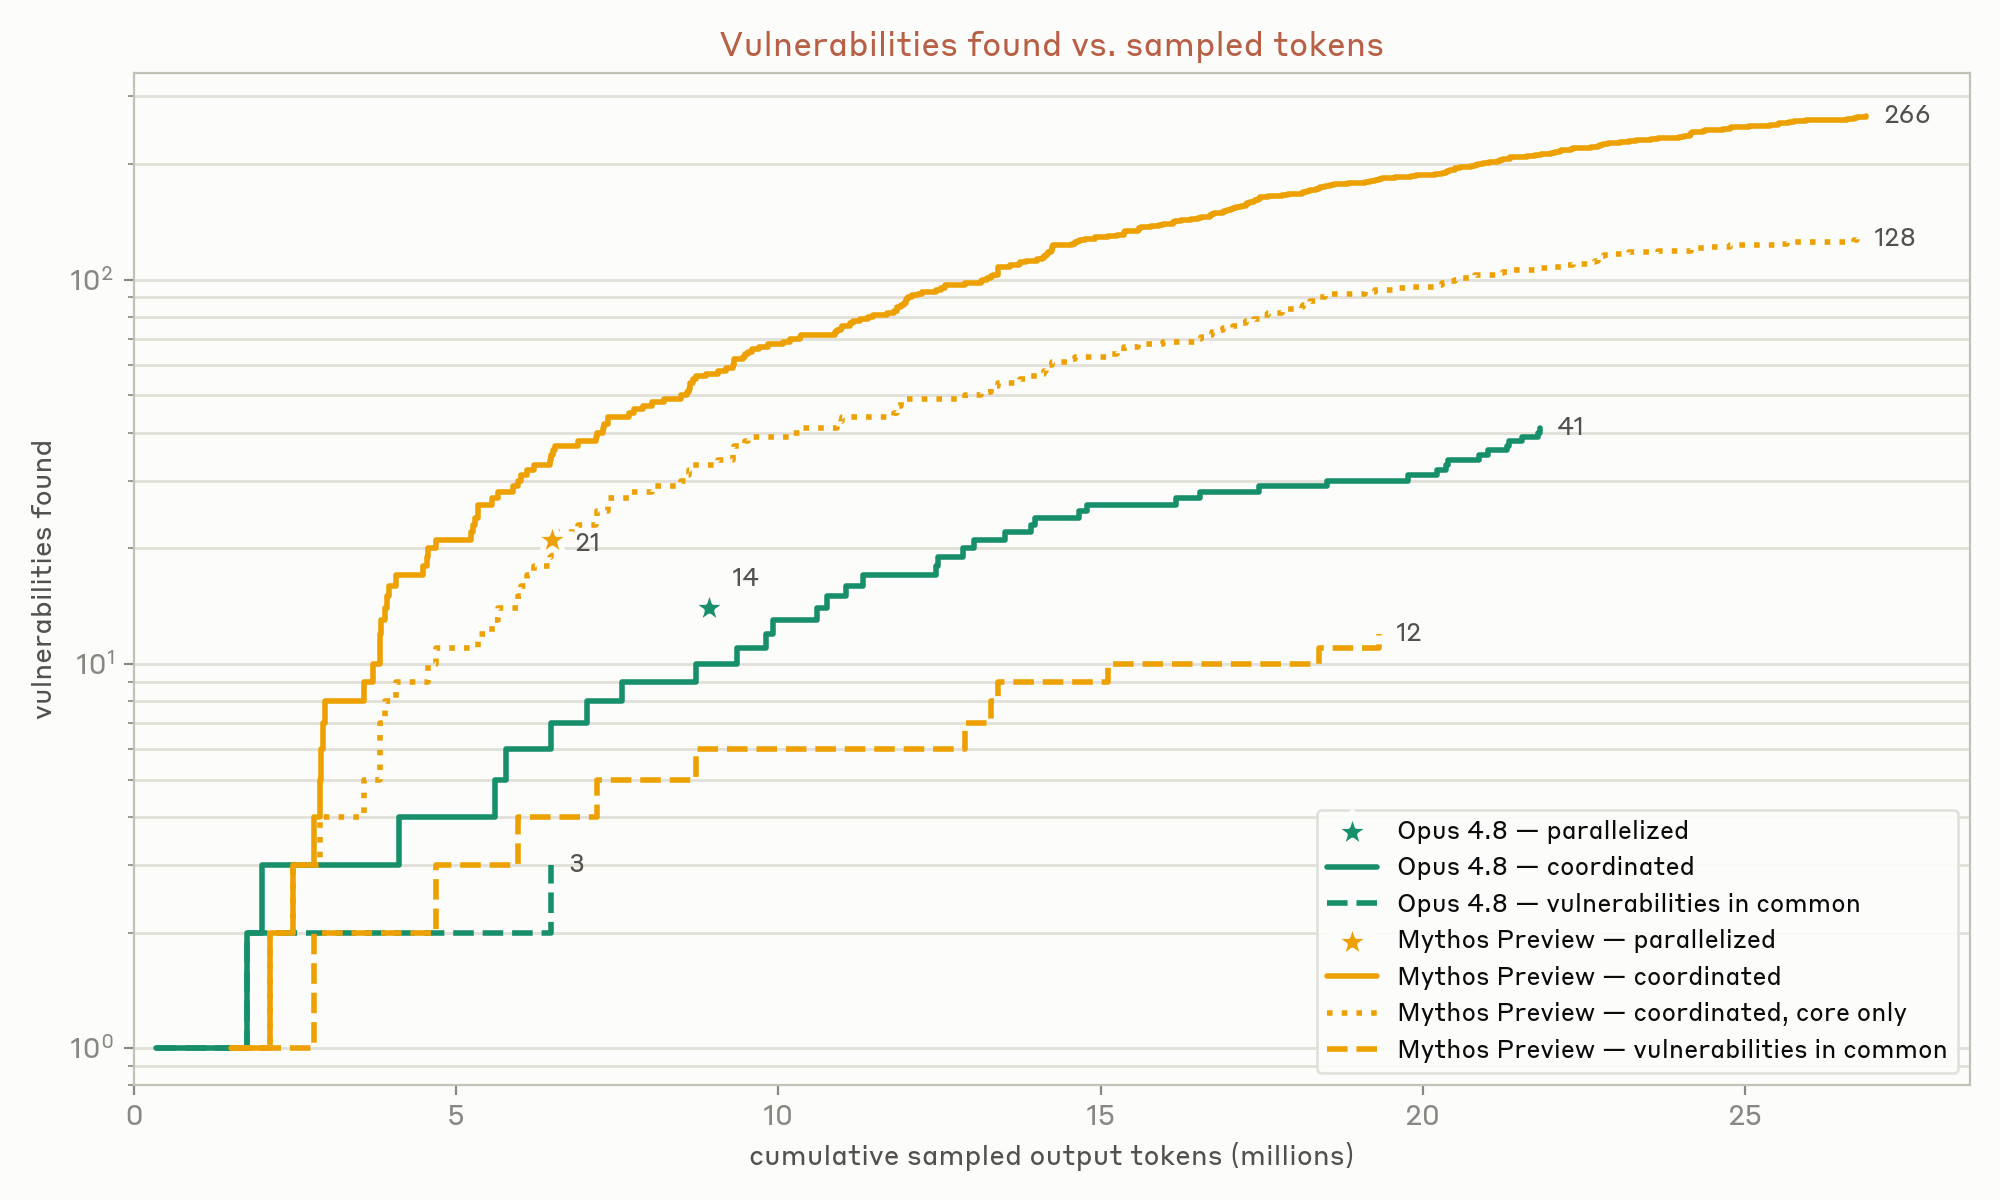
- Anthropic 前沿红队 8 月的 Patterns and problems in emerging multiagent systems 里,45 个 agent 组成的 swarm 在 15 个开源项目里找到 266 个漏洞,独立 agent 只找到 21 个,两边只重叠 12 个。但他们也看到了 swarm 的问题:30 个 agent 里有 18 个起了同一个分支名,一半以上去做了同类项目,agent 越多,成功合并的 PR 比例越低。
效率上也要冷静一点。Toby Ord 的 Swarm Scaling 根据 GPT-5.6 发布时的图做了个估算:\(N\) 个 agent 并行大约相当于一个 agent 工作 \(N^{\lambda}\) 倍时长,\(\lambda\) 在不同 benchmark 上大概是 0.5 到 0.7,也就是 10 倍的 agent 大约只值 3 到 5 倍的单 agent token。这是二手分析,但方向和 Google 的结论一致:swarm 并不省 token,它买的是速度,以及单 agent 根本达不到的上限。
总而言之,站在2026年10月的视角来看,我们现在需要 Agent Swarm这种形态的MAS,不是因为一个模型做不好某个子任务(第一阶段的前提基本被推翻了),也不只是因为一个窗口装不下(第二阶段是真的,但更像工程上的上下文管理)。最本质的原因是,很多真正有价值的问题,它的工作和探索空间超出了任何一条轨迹在有限时间里能覆盖的范围。这时候并发轨迹的数量,加上它们之间共享已验证进展的能力,就成了一个新的 scaling 维度,像参数、数据那样。
从目前的证据看,swarm 真正有收益大概需要三个条件:
- 任务足够宽、足够开放:可以拆成很多方向,而且方向之间不是强顺序依赖;
- 有便宜可靠的 verifier(评估器、测试、Lean、已知正确的 oracle):能筛选结果,保证共享出去的是已验证的进展;
- 每个 agent 有足够的预算:算力很少的时候,独立抽卡反而更划算。
不满足这些条件的时候,单 agent 加几个负责读和 review 的 subagent 大概率是更好的选择。